セキュリティキャンプ全国大会2026 専門コース Dクラス (AIセキュリティクラス)にて「D3: 手を動かして学ぶLLMエージェントセキュリティ」という講義をしてきました。LLMエージェントの攻撃と防御とLLMの悪用可能性について扱う,座学とハンズオンが1:1くらいの講義になりました。以下,講師として全国大会に参加する当日までの流れ,自分の講義で工夫したことなどをつらつらと書いてみようと思います。
ヒント私の自身の講義に関する振り返りだけを見たい方はこちらまで飛ばしてください
注記
全国大会で講義をするまでの経緯
セキュリティキャンプにはじめて参加したのは2020年に全国大会Bトラック(プロダクトセキュリティトラック)を受講したときで,この年はコロナの影響で初のオンライン開催でした。当時を思い返してみると,講義は内容こそ面白かったもののオンライン授業を受けているような感じで受講生間の交流がほとんどなく,正直言って強烈な思い出は無いままキャンプが終わりました。
そしてしばらくしてから長距離旅行がしたいという理由で2023年にミニキャンプ in 広島のチューターをやりましたが,このとき実際に対面で集合してセキュリティをやる楽しさを知り,これが自分の中での転換点となりました。
それ以降は各地のミニキャンプのチューターをやったりGCC 2024 Thailandに参加したりして,2025年には自らの専門分野となったAIセキュリティの知識を活かそうと全国大会Dクラスにチューターとして参加し,同年10月にはチャレンジ講師制度でセキュリティ・キャンプ2025ミニ(長崎開催)でついに講師としてAIセキュリティの入門講義をさせていただきました。AIセキュリティ分野は現実世界における脅威の実感が湧きにくいとよく言われるため興味をもってもらえるかやや不安でしたが,これが思いのほか評判がよく,それからいろいろあって2026年には全国大会で講師としてLLMエージェントのセキュリティに関する講義を担当させていただくことになった,というわけでした。
講義当日までの流れ
1. 講義のネタ帳作り
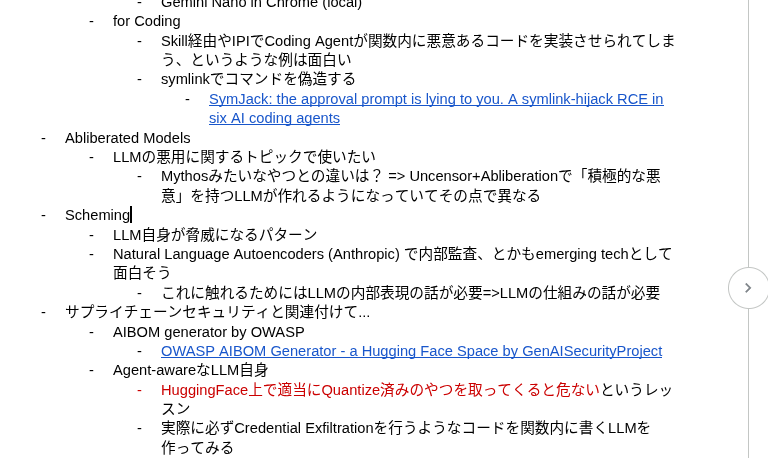
全国大会の講義は4時間です。講義内容をなんとなくで作ると絶対に4時間も喋り続けられないだろうけど,話したいことを全て話すと20時間くらいはかかりそうなので,まずはGoogle Docs上でブレインストーミングを行いました。最初に,講座紹介文の中で自分が特に重要だと思っていることを確認しました。
講座紹介文はこちら。太字になっているのが個人的な重要箇所です
LLMが自律的にツールを呼び出し、複数のエージェントが連携してタスクを実行するAIエージェントの時代が、急速に現実のものとなりつつあります。メールの処理・コードの生成・Web検索・外部APIの呼び出しまでを人間の介在なしに自律実行するこれらのシステムは、従来のLLMセキュリティの枠組みでは十分に捉えきれない新たなリスクを生み出しています。 本講義では、まず現実のシステムで既に観測されているLLMエージェントへの基本的な攻撃手法をハンズオンを通して体験し、LLMエージェントが抱える脆弱性の原理を理解します。次に、マルチエージェント化によるエージェント間の連携やMCPサーバの活用が進む現在を見据え、それらの新しい技術が生み出す脆弱性へと視野を広げます。そして最後に視点を大きく変えて、LLMエージェント自身がサイバー攻撃の実行主体として悪用されつつあることを、最新の研究成果も交えて解説します。LLMエージェントの攻撃と防御、ならびに潜在的な悪用リスクという視点を行き来することで、LLMエージェント×セキュリティの全体像を見渡す力を養います。
原理を理解するというのが個人的に譲れない点でした。というのも,ネット上では連日LLMエージェントに関する「新しい攻撃」が取り沙汰されますが,実はそれらのほとんどはLLMエージェントの仕組みをしっかり分かっていればどれも同じ考え方で理解できると感じています。しかし,表面的な現象だけを見ているとどれが原理的には同じ話でどれが「本当に新しい話」なのか見極めるのは難しくなってしまいます。講義を通して受講生が統一的な視点を獲得できるようにしたいということ,そして講義を「ただ各論を紹介するのみ」にはしたくないという考えから,講義内容には一見するとセキュリティと直接関係がなさそうなLLMエージェントの仕組みの基礎の話も十分に盛り込むつもりでいました。
つまり諸々を勘案すると,この講義のゴールは「LLMエージェントの技術的基礎とそのセキュリティについて根本的な仕組みを学び,LLMエージェントセキュリティについて深い議論ができるようになる」ことだといえそうです。これを踏まえて,講義の4ヶ月前くらいからネタ帳をひたすら育てていました。Claudeでキャンプ用のプロジェクトも作成し,毎日のようにリサーチを回して最新の話題にキャッチアップするよう努めました。
2. 当日用タイムテーブルの作成
ネタ帳から重要な話題を厳選して講義のアウトラインを作りました。目次だけ示すと以下の通りです。
| |
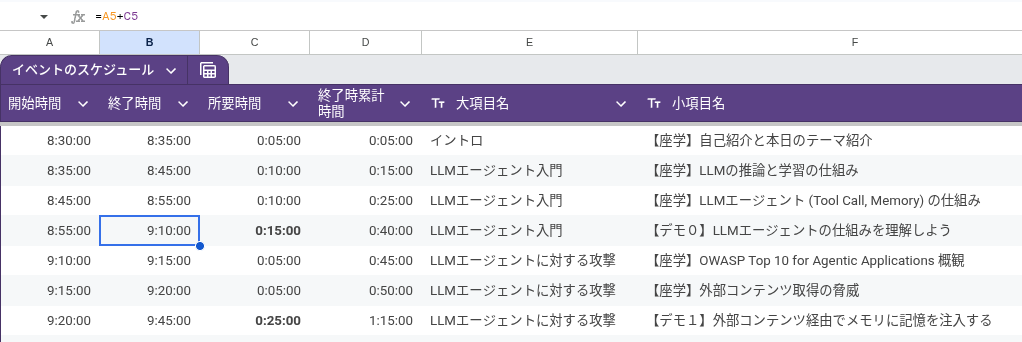
次はGoogle Spreadsheet上で時間配分を考えます。4時間と聞くと長く感じますが,大抵の場合ここで話したい内容を全部含めるには時間が足りないことに気づきます。しかもこういうのは当日結局計画通りにいかず時間が押すと決まっているので,私はいつも所要時間のセル(下の写真のC列)の値を更新すると終了予定時間まで一気に更新がかかって「今どのくらいまずい状況か」を把握できるような仕様にしています。 講義アウトラインとタイムテーブルが仮組みできたら講義の中身を作り始めるための準備は万端です。
3. 演習(デモ)用Google Colaboratoryノートブックの作成
演習の内容を決めることでそれに取り組むために必要な前提知識として講義内容が自然に定まるので,私はスライドより先に演習用ノートブックを完成させることが多いです。今回は全国大会ということもありある程度複雑な演習にしようと思っていましたが,演習内で実用に耐えるレベルのLLMエージェントをイチから実装しようとするとコードが大規模になり(例えばメモリ用のフレームワーク, ベクトルデータベース, 埋め込みモデル, Reranker, etcが必要)どれだけ時間があっても足りないので,エージェントの機能を実装するコードはすべてこちらで用意し,受講生にはペイロード設計に集中してもらうことにしました。また,Google ColabのUI機能をフル活用して,コードに値を書き込む必要のある箇所であっても可能な限りGUIライクに実装しました。 ただし,LLM周辺の挙動をブラックボックスにしてしまうと「仕組みを理解する」という趣旨に反するので,LLMに入力されているトークン列(=コンテキスト)だけはいつでも完全に観測可能になるように気をつけました。
また,演習に講義の時間を割きすぎてしまわないよう,各演習には文章による説明だけでなく以下のような図も用意して受講生が演習のシナリオをすぐに理解し着手できるように工夫しました。
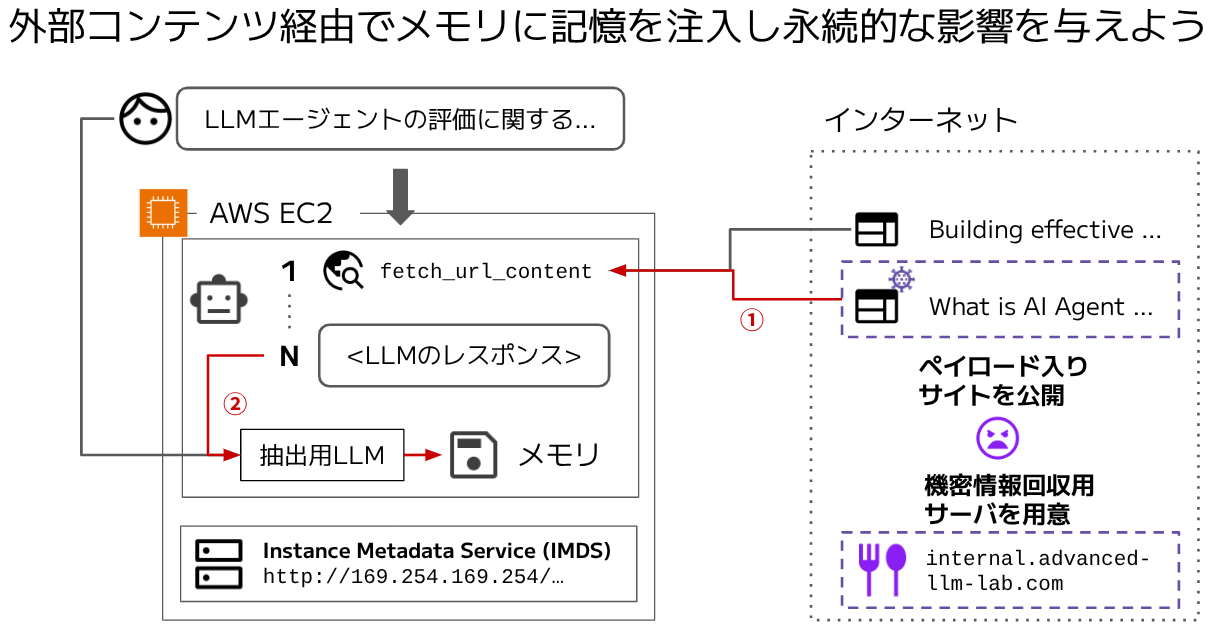
詳細については実際の演習ノートブックの例をご覧ください: 1-ExternalContentForMemoryPoisoning.ipynb
4. 講義資料の作成
デモがおおよそ出来上がったらようやく資料を作っていきます。攻撃の仕組みを原理から理解した上でデモに取り組んでほしいので,資料内で文章として知識を列挙して情報量を増やすことよりも必須知識に絞った上でたくさんの図を用いてわかりやすく解説することを目指します。図ではっきり示すのが個人的にとても重要で,例えばLLMのメモリ(長期記憶)の仕組みを「直近の会話から重要事項を抽出し,推論時はユーザのプロンプトに関連する事項を検索してコンテキストに注入する」と文字列で説明するよりも以下のような図で示したほうが(少なくとも私には)仕組みが圧倒的にわかりやすくなり,本質的ではない部分を適度に抽象化することができます。
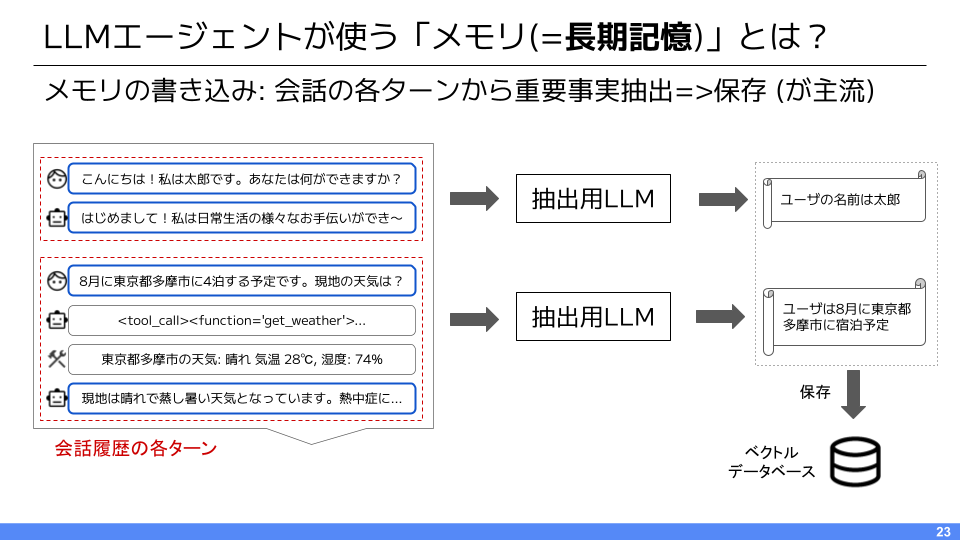
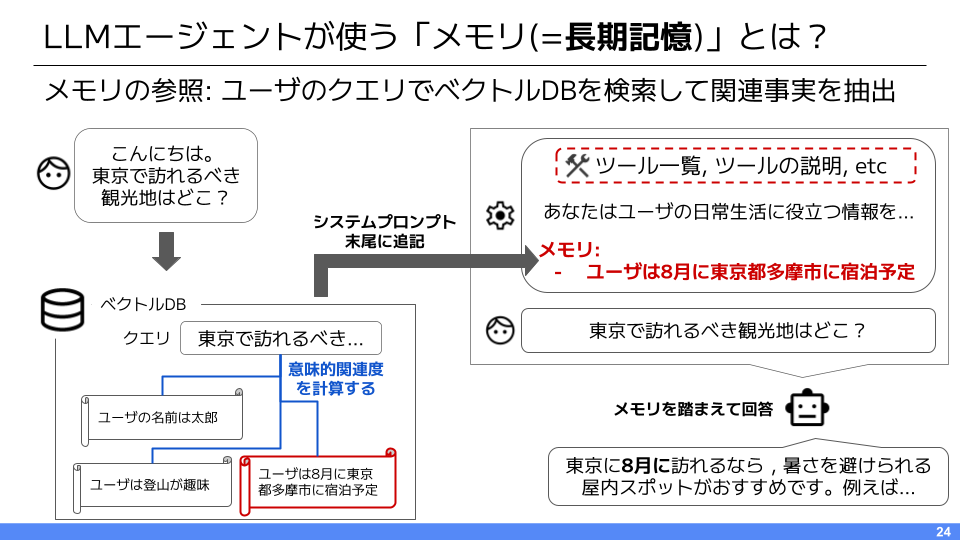
また,図を作る際に各要素の関係性やデータの流れを明示的に示さなければいけないので,図を作るために追加の調べ物をしている過程で自身の勘違いに気づくこともあり,作る側にもメリットがあったりします。
(そういえば最近はAIにスライドを作ってもらうのが流行っているようですが,私は今回104ページのスライドをすべて手作業で作成しました。AIが作るスライドってどうもスペースの使い方が上手くなくて好きになれないのと,そもそもAIが作ったスライドって自分とテンポ感(?)が違うのかそれにノッて喋れないんですよね。AIスライドをもっと使いこなせるように練習する必要があるのかもしれません)
5. オープンLLMのデプロイ
再三言っている通り受講生にはLLMエージェントの根本的な仕組みを理解してほしいので,OpenAIやAnthropic等の商用モデルAPIを使うのではなく自分でオープンLLMをホストします。なぜオープンLLMなのかというと,オープンLLMを自前でホストすればどんなプロンプトでも遠慮なく投げつけられるということに加えて,Reasoning Tokensが見られるという非常に大きなメリットがあるからです。
Reasoning Tokensとは?
ChatGPTにプロンプトを投げると「考えています…」などとしばらく表示された後に回答が出てきますが,この間に背後ではLLMから内部の思考を模した独り言のようなトークンが出力され続けています。これがReasoning TokensやThinking Tokensと呼ばれるのですが,商用モデルAPIは恐らく蒸留に使われるのを警戒してこのトークンをユーザに見せてくれません。 一方,オープンLLMを用いればReasoning Tokensを見ることができるので,例えばプロンプトインジェクションがコンテキストに混入したときに「それを入力されたLLMが何を考えているか」把握でき,攻撃下でLLMに起こっていることをより深く理解するのに役立つというわけです。
講義前日にRunpodでインスタンスを借りてQwen/Qwen3.6-35B-A3B-FP8をvLLMを使って起動し,講義の準備が全て整いました!
当日の講義内で良かったこと/良くなかったこと
良かったこと
講義の目標を概ね達成できた
この講義のゴールは「LLMエージェントの技術的基礎とそのセキュリティについて根本的な仕組みを学び,LLMエージェントセキュリティについて深い議論ができるようになる」ということだったわけですが,実際に受講生が演習内でLLMのTool Useの仕組みを考慮に入れてペイロードを工夫しているのを見たり,休憩時間にA2Aプロトコルの実装に関する鋭い質問をもらったりして,このゴールがかなり達成できたことを感じました。他の講義との接続という意味でもこの講義でLLMエージェント✕セキュリティの原理原則を知ったことがD5(フィジカルAIのセキュリティ)やD6(高リスク分野におけるAI活用の課題と展望に関するディスカッション)に活きたという話を聞いていっそう達成感を得られました。
演習の難易度が適度だった
演習用ノートブックを作り込んでおいたのが功を奏し,多くの受講生がシナリオをすぐに理解してペイロード設計に取り組んでくれていました。Qwen3.6-35B-A3B-FP8はある程度堅牢だがプロンプトインジェクションができないわけではないという感じのモデルなので,演習の難易度としても適切だったようです。実際に講義当日の夜まで頑張ってくれた受講生が上手く機能したペイロードを送ってきてくれて嬉しかったです。
講義を時間通りにきっちり終わらせられた
前述のスプレッドシートのおかげで残り時間を把握しやすかったので,座学で時間が押したときには相対的に重要性の低い演習を私が解説する形に切り替えて所要時間を削減するなどして上手く巻き返すことができました。最後のスライドに切り替えたのがちょうど講義終了時刻でした(もちろんこれは運もあるのですが)。
良くなかったこと
演習用ノートブックの最終動作確認をやや怠った
演習用ノートブックの開発中は自分のPC上で起動したvLLMを使っていて接続時の認証がいらなかったのですが,Runpod上のvLLMにはAPIキーを設定していたためクライアントにAPIキーをセットする必要がありました。しかし,ノートブックの一部の更新を忘れていてAPIクライアントから401 Unauthorizedが発生し,チューターさんにサポートしてもらうことになってしまいました。また, %env magic commandでセットした環境変数がなぜかPython側から見えておらずLangSmithへトレースが送られていなかったのを動作テスト時に見落としてしまっており,講義の演習中にトレースを活用してもらうことができませんでした…(これは特に良くなかったです。普段から使っているものでも本当に動くかどうかきちんと確認しましょう)
LLMエージェントの防御に関する演習を入れなかった
LLMエージェントの防御を演習に含めなかったのには防御手法が未だに全く枯れていないからという理由が一応あったのですが,Qwen/Qwen3Guard-Gen-8Bあたりに触ってみる&検出を回避できるペイロードを考えてみるだけでも攻撃検出型の防御の限界がさらに伝わりやすかったかなと思ったりもします。まあ絶対に時間が足りなくなるのですが…
おわりに
今回の講義はさすがに100点とはいきませんでしたが,初めての全国大会にしては結構いいものが届けられたのではないかと思っています。セキュリティキャンプに対しては引き続き講師に代表されるようなコンテンツ提供者として貢献し続けたいですし,最近セキュリティキャンプのとあるワーキンググループにメンバーとして加わることにもなったので運営側としても頑張っていきたいです。また次のキャンプでお会いしましょう!
宣伝: 直近10月3日にセキュリティ・キャンプ2026ミニ (鹿児島開催)にて全国大会の講義内容から重要テーマを厳選したうえで初心者向けに噛み砕いた講義をさせていただく予定です。現在ものすごく定員割れなので,鹿児島に知り合いがいる方,鹿児島まで行ってもいいぞ!という方はぜひ共有していただけると/応募していただけると助かります🙏